
Por que qualidade de dados importa? Dados ruins levam a decisões erradas, modelos de machine learning imprecisos e perda de confiança nos sistemas. Se você já tem um conhecimento básico de Python e dados, este guia vai te mostrar como usar a PyDeequ para implementar um programa de qualidade de dados na sua empresa, passo a passo.
Fluxograma
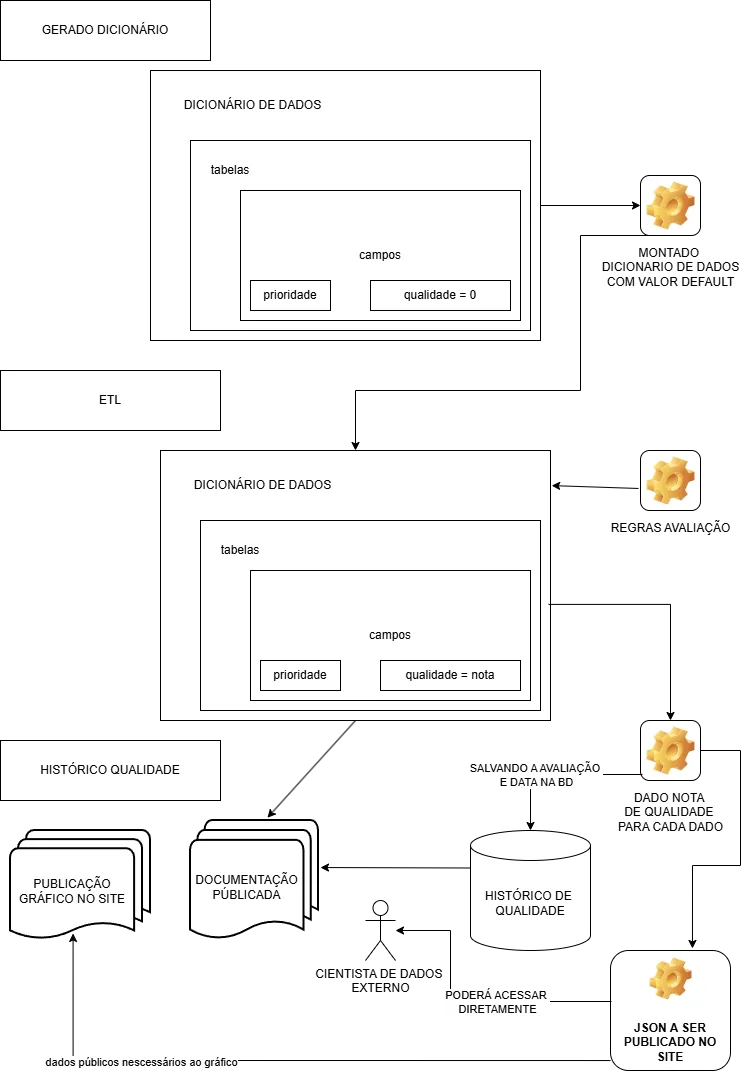
1. Resumo do Conhecimento sobre Qualidade de Dados (Foco em PyDeequ)
A qualidade de dados é um aspecto crítico em projetos de dados, e diversas ferramentas foram criadas para garantir que os dados sejam confiáveis. As duas mais conhecidas são a Great Expectations e a PyDeequ. Como nosso foco aqui é a PyDeequ, vamos entender o que ela é e como se compara à concorrente.
1.1 O que é PyDeequ?
A PyDeequ é a API Python para o Deequ, uma biblioteca construída sobre o Apache Spark para definir “testes unitários para dados”. Isso significa que você pode criar verificações automatizadas que rodam em grandes volumes de dados de forma distribuída e escalável.
Ela possui quatro componentes principais:
- Metrics Computation (Analyzers): calculam métricas como completude, distinção, entropia, correlação, média, desvio padrão, entre outras.
- Constraint Suggestion: analisa os dados e sugere regras de qualidade automaticamente, o que ajuda a começar rapidamente.
- Constraint Verification (Checks): executa validações com base em restrições definidas por você, retornando status de sucesso, aviso ou erro.
- Metrics Repository: permite armazenar e rastrear execuções ao longo do tempo, facilitando análises de tendências e auditoria.
1.2 PyDeequ vs. Great Expectations: Quando usar cada uma?
| Critério | Great Expectations | PyDeequ |
|---|---|---|
| Facilidade de uso | Alta, com API declarativa e documentação automática. | Moderada, requer conhecimento de Spark e configuração de ambiente. |
| Escalabilidade | Boa, mas não nativa para processamento distribuído massivo. | Excelente, aproveita o poder do Spark para grandes volumes. |
| Integração | Ampla: SQL, pandas, Spark, arquivos, etc. | Focada no ecossistema Spark (DataFrames, RDDs). |
| Documentação automática | Sim, com Data Docs ricos e compartilháveis. | Não nativa; requer geração de relatórios externos. |
| Melhor cenário | Equipes multidisciplinares, pipelines variados, necessidade de transparência. | Big Data, processamento distribuído, ambientes Spark já consolidados. |
Resumindo: se sua empresa já usa Spark e lida com grandes volumes de dados, a PyDeequ é a escolha natural. Se a prioridade é facilidade de uso e integração com múltiplas fontes, a Great Expectations se sobressai. É possível até usar as duas em cenários complementares.
1.3 Dimensões de Qualidade Cobertas pela PyDeequ
A PyDeequ permite avaliar diversas dimensões de qualidade, como:
- Completude: percentual de valores não nulos (analyzer
Completeness). - Unicidade: ausência de duplicatas (analyzer
Uniqueness). - Validade: conformidade com tipos e padrões (analyzers
DataType,PatternMatch). - Consistência: coerência entre colunas (analyzer
Correlation). - Distribuição: histogramas e quantis (analyzers
Histogram,ApproxQuantile). - Informação: entropia e informação mútua (analyzers
Entropy,MutualInformation).
Além disso, os Checks permitem criar validações como isComplete, isUnique, hasPattern, isContainedIn, hasSize, hasMean, hasStandardDeviation, entre muitas outras.
2. Planejamento Estratégico para Implementar PyDeequ na Sua Empresa
A seguir, um roteiro detalhado em passos numerados, pensado para quem já tem um conhecimento básico de Python e quer implementar a PyDeequ de forma estruturada.
- Diagnóstico Inicial e Mapeamento de Ativos de DadosAntes de escolher a PyDeequ, entenda o ecossistema de dados da empresa:
- Fontes de dados (bancos, data lakes, APIs, arquivos).
- Volumetria e frequência de atualização (batch, streaming).
- Criticidade dos dados para o negócio.
- Consumidores: cientistas de dados, engenheiros, analistas de BI.
Realize entrevistas com stakeholders para levantar dores atuais. Documente os principais fluxos de dados (data pipelines) e os pontos de falha conhecidos.
- Definição de Metas e Dimensões de Qualidade PrioritáriasCom o diagnóstico em mãos, estabeleça metas mensuráveis. Por exemplo: “reduzir em 30% o número de registros com campos obrigatórios nulos no pipeline de vendas em 3 meses”. Escolha as dimensões mais críticas:
- Completude: percentual de valores não nulos em campos essenciais.
- Unicidade: ausência de duplicatas em chaves primárias.
- Validade: conformidade com tipos, formatos e domínios.
- Consistência: coerência entre diferentes fontes ou tabelas.
- Tempestividade: dados disponíveis no tempo esperado.
Priorize as dimensões que impactam diretamente os produtos de dados e as decisões estratégicas.
- Confirmação da Escolha da PyDeequA PyDeequ é ideal se:
- A empresa já possui infraestrutura Spark consolidada.
- Os volumes de dados são grandes (big data).
- Há necessidade de processamento distribuído e escalável.
- A equipe tem conhecimento de Python e Spark.
Caso contrário, avalie a Great Expectations como alternativa. Em cenários mistos, é possível usar as duas ferramentas complementarmente.
Realize um projeto-piloto (proof of concept) com uma fonte de dados crítica para validar a ferramenta, medindo esforço de implementação, desempenho e aderência às necessidades.
- Preparação do Ambiente e Infraestrutura
- Definição e Implementação de Regras de Qualidade (Checks e Analyzers)Comece com um conjunto enxuto de regras de alto valor.
💡 Dica: Comece com 5 a 10 regras que cubram os problemas mais críticos. Não tente criar centenas de regras de uma vez.
- Integração nos Pipelines de Dados (DataOps)A qualidade de dados deve ser contínua e automatizada. Incorpore as verificações nos seguintes pontos:
- Ingestão: valide os dados brutos antes de gravá-los na camada de armazenamento (bronze).
- Transformação: execute checagens após cada etapa crítica de ETL/ELT (camadas silver e gold).
- Pré-publicação: antes de disponibilizar um dataset para consumo, rode a suíte completa de validações.
- Monitoramento agendado: execute verificações periódicas para detectar desvios em dados já publicados.
Use orquestradores como Apache Airflow, Dagster ou Prefect para agendar e monitorar as execuções. Em caso de falha, dispare alertas (e-mail, Slack) e bloqueie a propagação de dados incorretos (fail-fast).
- Armazenamento e Análise Histórica de MétricasUtilize o Metrics Repository para persistir os resultados das análises.Com o histórico em mãos, crie dashboards (Grafana, Power BI, Metabase) para acompanhar a evolução da qualidade ao longo do tempo.
Governança, Documentação e Cultura de Qualidade
Estabeleça um comitê de qualidade de dados com representantes de engenharia, ciência de dados e negócio. Defina papéis e responsabilidades:
- Data Stewards: responsáveis por definir e manter as regras de qualidade para domínios específicos.
- Data Engineers: implementam e mantêm as verificações nos pipelines.
- Data Consumers: reportam problemas e validam a correção.
Documente todas as regras, seu racional e os resultados esperados. Como a PyDeequ não gera documentação automática nativa, crie relatórios periódicos em Markdown ou HTML a partir dos resultados dos checks.
Promova treinamentos e workshops para disseminar a cultura de qualidade de dados. Celebre casos de sucesso e aprenda com falhas.
Evolução Contínua e Escalonamento
Comece com um escopo reduzido (um pipeline crítico) e expanda gradualmente.
Monitore indicadores como:
- Número de regras de qualidade ativas.
- Taxa de falhas por dimensão de qualidade.
- Tempo médio para detecção e correção de incidentes de dados.
- Cobertura de datasets críticos com validações automatizadas.
À medida que a maturidade aumenta, incorpore técnicas mais avançadas: detecção de anomalias (ex.: KLLSketch), comparação de distribuições históricas, validação de dados em streaming (Spark Structured Streaming) e integração com catálogos de dados (DataHub, Amundsen).
Avalie periodicamente a necessidade de adotar ferramentas complementares, como Soda, Monte Carlo, ou até mesmo soluções comerciais, sempre alinhadas à estratégia de dados da empresa.
Encerramento e Shutdown Adequado (Boas Práticas)
Ao final de cada job PyDeequ, garanta o encerramento correto da sessão Spark para evitar processos pendentes e vazamento de recursos:
Conclusão
A implementação de um programa de qualidade de dados com PyDeequ é uma jornada, não um projeto finito.
O planejamento estratégico aqui delineado em 10 passos permite que profissionais com conhecimento intermediário conduzam a adoção de forma estruturada, escalável e alinhada ao negócio.
Lembre-se: a ferramenta é um meio; o fim é a confiança nos dados e a geração de valor a partir deles.
Comece pequeno, mas pense grande e continuamente.
Boa jornada!