Engenharia e Qualidade de Dados: Guia para Iniciantes


Engenharia e Qualidade de Dados: Guia para Iniciantes


Você que está começando agora na área de dados precisa entender que qualidade de dados não é um luxo, é uma necessidade. Neste post, vou resumir o material do curso e montar um passo a passo simples para você entender como tudo funciona — mesmo sem conhecimento prévio. Vamos lá!


1. O cenário: Banco Pantanal e a transformação digital

O Banco Pantanal é um banco regional do Centro-Oeste que decidiu investir forte no digital. Para competir com grandes bancos, criou uma diretoria de dados e construiu um Data LakeHouse — uma arquitetura que une o melhor do lago de dados (flexibilidade) com o armazém de dados (organização).

A missão inicial: criar um dashboard de vendas para a diretoria em dois meses. Mas, ao validar os dados com a equipe de vendas, descobriram vários problemas: dados faltando, duplicados, classificações erradas e valores inconsistentes. O dashboard não refletia a realidade.

💡 Lição 1: Sem qualidade de dados, qualquer decisão baseada em dados é perigosa. Confiança é a base de tudo.


2. Onde os problemas de qualidade surgem?

Os problemas podem aparecer em quatro momentos principais:

  1. Coleta: se o dado não é capturado corretamente na origem (ex.: sensor falhou, sistema não registrou a venda), dificilmente será recuperado.
  2. Integração: ao transferir dados de um sistema para outro, erros podem ser introduzidos (ex.: perda de rastreabilidade).
  3. Pipelines (transformações): lógicas incorretas ou configurações erradas nas etapas Bronze → Silver → Gold podem gerar novos erros.
  4. Interpretação: regras de negócio mal aplicadas ou agregações sem fundamento distorcem o significado do dado.
📌 Exemplo real do curso: o pipeline validava estados brasileiros, mas colocou “DE” em vez de “DF” (Distrito Federal). Esse erro fez com que dados do DF fossem tratados como inválidos.

3. Quem é responsável pela qualidade?

Muita gente participa do processo. Os principais papéis são:

  • Data Owner (proprietário do dado): é o responsável final pela qualidade. Responde por erros e define regras de negócio.
  • System Owner (dono do sistema de origem): garante a captura correta na fonte.
  • Data Stewards / Equipe de Qualidade: implementam e monitoram regras de qualidade.
  • Engenheiros de Dados: constroem pipelines. Se mal projetados, introduzem erros.
  • Consumidores de Dados: identificam problemas e dão feedback.

Ou seja, a qualidade é responsabilidade de todos, mas o Data Owner é o accountable final.


4. Onde medir a qualidade de dados?

A resposta curta: em todos os momentos possíveis. Mas isso não é trivial. Existem dois enfoques de mercado:

  • Enfoque na camada Gold (uso): ferramentas como Microsoft Purview, Collibra ou AWS Glue Data Quality avaliam a qualidade no ponto de consumo. É mais simples, mas erros de etapas anteriores já se propagaram.
  • Enfoque distribuído nas camadas (LakeHouse): mede-se qualidade na Bronze, Silver e Gold. É mais trabalhoso, porém identifica a origem do problema mais rapidamente e reduz custo de correção.

Quanto mais tarde você descobre um erro, mais caro é corrigi-lo. Por isso, medir cedo (na fonte ou na Bronze) é essencial.


5. Passo a passo para garantir qualidade de dados

Agora, o coração do post: um roteiro prático para iniciantes.

Passo 1Entenda o fluxo de dados

Mapeie de onde os dados vêm, por quais camadas passam (Bronze → Silver → Gold) e quem os consome. Use ferramentas de linhagem (ex.: SQL Flow) para visualizar transformações coluna por coluna.

Passo 2Crie contratos de interface

Entre o sistema de origem e a camada Bronze, defina: esquema (tipos de dados), temporalidade (frequência de atualização), responsabilidades e regras mínimas de qualidade. Exemplo: “todo mês devemos ter 10 mil linhas novas”.

Passo 3Implemente um motor de qualidade na Bronze

Use ferramentas como Great Expectations, PyDeequ ou similares para medir a qualidade dos dados brutos. Isso permite decidir conscientemente se vale a pena usar aquele dado ou se é preciso negociar com a origem.

Passo 4Harmonize e padronize na Silver

Aplique convenções de nomenclatura (ex.: “unidade_federativa” em vez de “estado”), use dados de referência (ex.: tabela com todos os estados brasileiros) e crie uma base comum de regras de validação. Assim, você remove responsabilidade excessiva dos engenheiros e garante consistência.

Passo 5Oriente a qualidade ao negócio na Gold

Na camada de consumo, cada caso de uso tem expectativas diferentes. Estabeleça contratos de dados entre produtores e consumidores, definindo SLAs (ex.: “erros serão corrigidos em até 24h”) e regras específicas por área (marketing, compliance, machine learning etc.).

Passo 6Defina responsáveis e prioridades

Monte um Centro de Excelência (CoE) com pessoas seniores. Para cada iniciativa, defina quem atua e quem é responsável. Priorize capacidades técnicas: primeiro o motor de qualidade, depois dados mestres/referência, e por fim a base comum de regras.

Passo 7Monitore e melhore continuamente

Use orquestração para agendar pipelines, monitore falhas e mantenha a documentação atualizada. A qualidade de dados é uma jornada, não um destino.


6. Ferramentas e técnicas mencionadas no curso

  • Contratos de interface: formalizam regras entre origem e Bronze.
  • Contratos de dados: formalizam expectativas entre produtor e consumidor (Gold).
  • Dados mestres e de referência: bases centralizadas para validação (ex.: clientes, agências, códigos de bancos, estados).
  • Naming conventions: padronização de nomes de colunas e tabelas.
  • Padrões empresariais de dados: regras corporativas (ex.: data sempre no formato dd/mm/aaaa).
  • Motor de qualidade: software que executa verificações automáticas (Great Expectations, PyDeequ, etc.).
  • SQL Flow: ferramenta para visualizar linhagem e transformações.
  • Excalidraw: para desenhar arquiteturas.

7. Conclusão

Qualidade de dados não é apenas “limpar planilhas”. É uma disciplina que envolve pessoas, processos e tecnologia. No caso do Banco Pantanal, a criação de um Centro de Excelência e a implementação de um Data LakeHouse com camadas bem definidas permitiram que a empresa começasse a confiar nos dados para tomar decisões.

Para você que está começando, lembre-se: comece pequeno, mas comece certo. Entenda o fluxo, defina responsabilidades, meça a qualidade o mais cedo possível e use as ferramentas certas. Assim, você constrói uma base sólida para qualquer iniciativa de dados.

🚀 Dica final: A qualidade dos dados é responsabilidade de todos, mas o Data Owner é quem responde por ela. Trabalhe em conjunto com governança, engenharia e qualidade para garantir que os dados sejam confiáveis do início ao fim.


Post baseado no curso “Engenharia e Qualidade de Dados” – Alura. Bons estudos!

Documentação da gestão de dados do Site

Objetivo deste Post:

Documentar, Praticar, Exemplificar processos da Gestão de Dados em pequena escala com baixo custo.

Conceito de dados de referência:

São dados internos ou externos padronizados que servem para classificar, categorizar ou codificar outros dados. São definidos por órgãos oficiais (IBGE, BACEN, ANS, Receita Federal) ou por padrões do setor, e raramente mudam. Diferente dos dados mestres, não descrevem entidades da organização — descrevem categorias universais que a organização apenas usa como referência. A padronização interna deve ser feita de forma colaborativa, envolvendo representantes de cada departamento para discutir e acordar uma definição comum para as categorias de usuários, e criar um comitê de dados para revisar e aprovar definições de dados de referência.

Selecionado Referência do site Área de Trampo Norma Formato Exemplo
■ Padrão Oficial Brasileiro de Data ABNT NBR 5892 DD/MM/AAAA 04/10/2026


Critérios para escolher a melhor fonte para um dado de referência:

  • Autoridade – Conhecimento e Legitimidade. Verifique quem já consome estes dados. Verifique o Órgão competente.
  • Atualidade – Qual a nescessidade da atualidade ? Verifique o cronograma para a atualização.
  • Completude – Quanto está completo ? Qual a nescessidade de completude ?
  • Unicidade – Existe mais de uma fonte que gera essa fonte de dado ? Deve ser evitado varias fontes do mesmo dado em nossa empresa.
  • Custo – Verifique se a fonte é gratuíta.


Tipos de dados de referência:

  • Geográficos e Geoestatísticos tem pouca atualização (Dados de localização e decisões políticas) e
  • Computacionais (Taxa de Câmbio) mudam com frequência

Tipos de estruturas utilizadas em Dados de Referência

Selecionado Estrutura O que é Exemplo
■ Lista Simples Conjunto de valores padronizados, sem hierarquia e sem relação com outros conjuntos. Cada código representa um único conceito. Porte da empresa:
G = Grande
M = Médio
P = Pequeno
☐ Lista de Referências Cruzadas Tradução entre diferentes conjuntos de códigos que representam o mesmo conceito. Permite integrar sistemas que usam padrões distintos. País: Brasil
• Código do País: Brasil
• ISO alfabético: BR
• FIFA/COI: BRA
• ISO numérico: 076
• DDI: 55
☐ Taxonomias Estrutura hierárquica que decompõe um conceito em níveis, do mais genérico ao mais específico. Cada nível refina o significado do anterior. NCM 6109.10.00 — “Camiseta de malha de algodão para uso masculino”
61 — CAPÍTULO: “Vestuário e seus acessórios de malha”
09 — POSIÇÃO: “Camisetas e camisetas interiores, de malha”
.10 — SUBPOSIÇÃO: “De algodão”
.0 — ITEM: “Camisetas de malha de algodão — geral”
.0 — SUBITEM: “Camisetas de malha de algodão (geral, sem detalhamento adicional específico)”

Tipos de arquitetura para dados de referência

Selecionada Tipo de Arquitetura Descrição Vantagens Desvantagens
☐ Centralizada Sistema centralizado onde os responsáveis gerenciam o ciclo de vida
dos dados de referência da empresa.
  • ✓ Unicidade da fonte da verdade
  • ✓ Controle centralizado de versões
  • ✓ Rastreabilidade completa de todas as alterações
  • ✓ Facilidade de auditoria
  • ✕ Requer uma plataforma dedicada
  • ✕ Pode gerar gargalo
  • ✕ Exige adequação dos sistemas consumidores
■ Federada Não centralizado: cada domínio de dados de referência tem um sistema
de origem autorizado para fornecer o dado que lhe compete às demais
áreas consumidoras da empresa.
  • ✓ Não requer a implantação de nova plataforma dedicada
  • ✓ Aproveita os sistemas já existentes
  • ✓ É fácil de implementar
  • ✕ Falta de clareza da autoridade
  • ✕ Exige maturidade em governança nas áreas
  • ✕ A governança fica fragmentada
  • ✕ Difícil ter uma visão global de todos os dados de referência da organização


Modelos de Distribuição de Dados de Referência:

Selecionado Modelo de Distribuição Descrição Vantagens Desvantagens
☐ Tempo Real via API Consulta em tempo real ao repositório de dados de referência
por meio de chamada direta a uma API. Os sistemas consumidores
obtêm o dado no momento em que precisam dele.
  • Dados sempre atualizados
  • Estrutura de servidores de API
■ Replicação periódica (Batch) Cópia local periódica dos dados de referência para dentro do
sistema consumidor, com dependência de autorização. Pode ser
implementado rapidamente aproveitando a infraestrutura existente.
  • Cópia local periódica com dependência de autorização
  • Pode ser implementado rapidamente
  • Pode gerar dados desatualizados
  • Para evitar dados desatualizados, exige monitoramento ativo
☐ Direcionada por Eventos Ocorre quando uma alteração é aprovada no repositório e, neste
momento, dispara-se um evento para publicação em um barramento
de mensagens. Todos os consumidores inscritos no barramento recebem
a atualização automaticamente — ou seja, o consumidor não precisa
checar periodicamente se há novas atualizações, ele as recebe
quando houver o evento (autorização).
  • É mais proativo
  • É desacoplado (o sistema não conhece os sistemas consumidores)
  • É escalável (permite facilmente o aumento de consumidores)
  • Requer uma infraestrutura de mensageria
  • É mais complexo de implementar e monitorar
  • Exige que os sistemas consumidores sejam capazes de processar eventos de forma assíncrona
☐ Modelo Híbrido Combinação dos modelos anteriores, adotando o melhor de cada
abordagem conforme o contexto de cada domínio de dados de
referência e as capacidades dos sistemas consumidores.
— —


Modelagem de Dados de Referência:

Selecionado Componente Descrição Detalhamento
■ Metadados Documentam e descrevem o dado de referência, promovem contexto, viabilizam a governança, permitem a descoberta e o reuso, preservam a interpretabilidade histórica
Exemplo Padrão para JSON em Área de Trampo:

 
  • Data e hora de criação
  • Fonte de origem
  • Data e hora de alteração
  • Usuário que o criou/alterou
  • Motivos de alterações
  • Histórico de conteúdo
  • Usuários que consultaram
☐ Status Ativo ou Inativo
  • Nunca exclua um dado fisicamente em uma tabela
  • Desative via status em vez de apagar o registro
☐ Versionamento Dados de referência mudam, cada mudança tem impacto nos sistemas consumidores e análises. Versionamento significa registrar o histórico completo de cada tabela.
Tipos Versionamento:

  • Por Registro (sabemos qual registro está ativo e se nescessário podemos ainda acessar os registros históricos que na época eram os registros vigentes)
  • Por Snapshot (fotografia) de tabela (neste caso a tabela inteira é fotografada a cada mudança aprovada, mais simples de entender mas custoso em armazenamento).
  • Versionamento significa registrar o histórico completo de cada tabela


Modelagem Hieráquica

Selecionado Tipo de Hierarquia Descrição
☐ Hierarquias simples (2 níveis) Estrutura com apenas dois níveis hierárquicos: um nível pai
e um nível filho. Relação direta e sem subdivisões adicionais.
■ Hierarquias profundas (N níveis) Estrutura com múltiplos níveis hierárquicos (N níveis),
permitindo subdivisões sucessivas a partir de um nível raiz
até folhas em profundidade arbitrária.


Dados Transacionais:

Selecionado Tipo de Dado Descrição
■ Dados Transacionais Dados que registram eventos e operações do dia a dia da organização —
cada venda, cada atendimento, cada movimentação. São gerados continuamente,
mudam o tempo todo e referenciam os dados mestres para ganhar significado.
Sozinhos, são apenas registros; combinados com dados mestres, viram informação.


Glossário de Negócio × Dicionário de Dados

Aspecto Glossário de Negócio Dicionário de Dados
Foco Conceito / significado Implementação / estrutura
Pergunta-chave “O que é?” “Como está armazenado?”
Público Negócio, gestores, analistas TI, engenheiros, DBAs
Linguagem Natural, sem jargão técnico Técnica (tipos, formatos, chaves)
Granularidade Termo de negócio Coluna / campo
Exemplo de entrada “Bilheteria = arrecadação total de ingressos” vl_bilheteria DECIMAL(10,2) NOT NULL
Frequência de mudança Raramente (conceito é estável) Frequentemente (estrutura evolui)
Quem mantém Data Steward de negócio Engenheiro de dados / DBA
Ferramenta típica Collibra, DataHub (glossário) DataHub, Atlas, dbt docs
Relação entre eles 1 termo → N campos técnicos 1 campo → 1 termo


1. Padrões Organizacionais

Dado Tipo_de_Dado Complemento
Data Date DD/MM/AAAA
Valor Monetário Ponto Flutuante 50000.35
Comentários no código String Em língua portuguesa


Finalidade de padronização na empresa:

  • Regras e diretrizes para a qualidade e consistência dos dados
  • Reduzem incertezas
  • Aceleram implementação
  • Reduzem riscos
  • Aumentam Qualidade de Dados


Como aumentar a escala de padronização:

  1. Documentação dos padrões
  2. Única fonte da verdade (tabela)
  3. Implementação do padrão
  4. Excelência operacional


2. Dados Mestres:

Dados sobre as entidades de negócio centrais que são compartilhados entre múltiplos sistemas, processos e áreas da organização, e que raramente mudam, mas cuja consistência é crítica para a operação. São essenciais e confiáveis em toda a organização.

Nome Fonte resultado

Unidades_Federativas  e Municípios 
CONSTANTE CAPITAIS =

  • API do IBGE ESTADOS : https://servicodados.ibge.gov.br/api/v1/localidades/estados
  • API do IBGE MUNICÍPIOS: https://servicodados.ibge.gov.br/api/v1/localidades/estados/{uf}/municipios
  • API do IBGE POSIÇÃO GEOGRÁFICAS: :https://servicodados.ibge.gov.br/api/v4/malhas/municipios/{geocodigo}?formato=application/vnd.geo+json
JSON


3. Responsabilidade

Accoutability (Responsável) pela gestão e uso dos dados, nesta faze definimos quem são os  Data Owner’s e Data Steward’s.

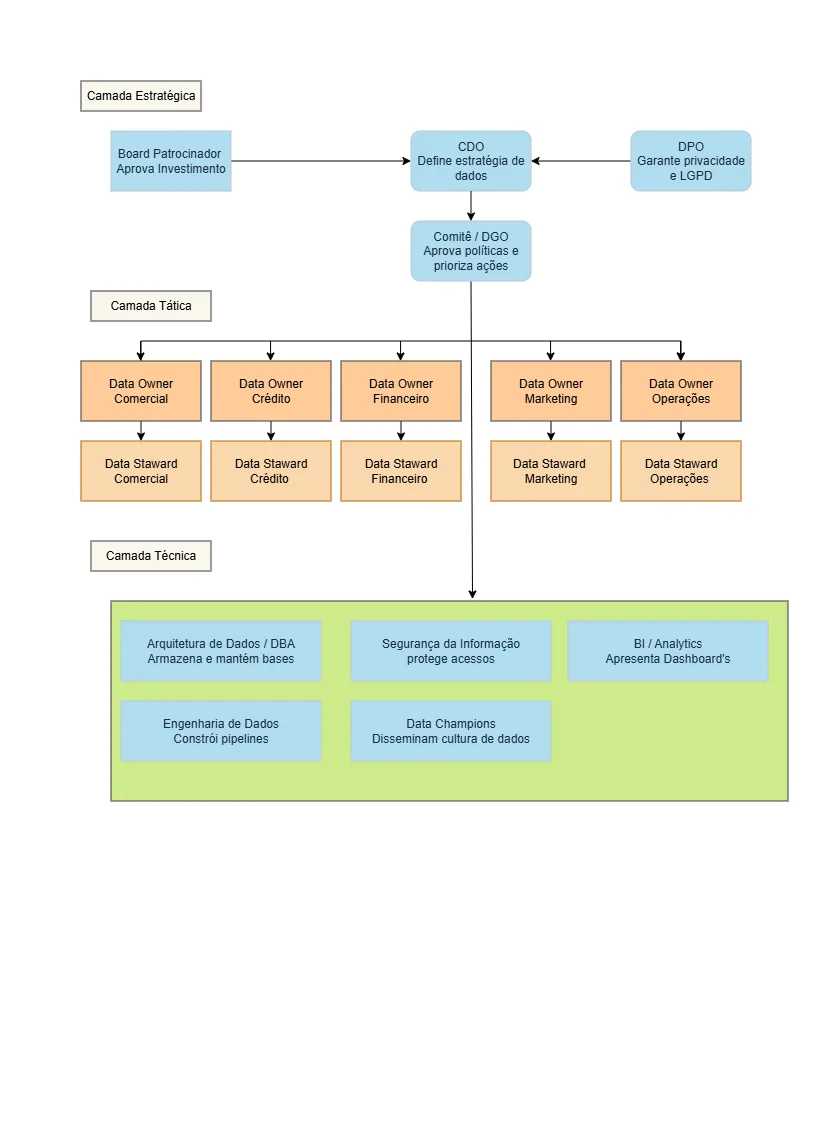
4. Papéis e responsabilidades

  • Consumidores – Uso da fonte oficial, comunicar problemas de qualidade, contribuir para o aprimoramento do nível de qualidade.
  • Data Owner – É pessoa da área do negócio e responsável por um domínio específico de dados de referência que ele domina e não é necessário ter atributos técnicos.
  • Data Steward – É o responsável operacional pela gestão diária do domínio de dados de referência (curador, avalia as solicitações de criação ou alteração, conduz a análise de impacto, monitora os indicadores de qualidade e identifica e reporta problemas)
  • CDO Chief Data Officer – É o principal responsável
  • Comitê – Juntamente com o CDO tomam decisões estratégicas, acompanham os indicadores, priorizam as iniciativas e têm abrangência corporativa.


5. Comitê de Dados (Se aplica a empresas Médio e Grande Porte)

  • Capacidade de juntar pessoas com poder descisório na organização
  • Definição em temas transversais dentro da organização
  • Formalização e identificação de responsáveis mediada a governança
  • Mediação (facilitando acordo entre as partes)

5.1. Composição do Comitê de Dados

  • Representantes das Áreas de Negócio – perspectivas práticas sobre o uso e melhoria dos dados.
  • Chief Data Office (CDO) – Estratégia de dados e alinhamento organizacional
  • Representantes da Governança de Dados – políticas para qualidade, seguridade e conformidade de dados
  • Outros Stakholders Interessados – Incluem especialistas em TI, compliance e segurança.


6. Políticas de Governança de Dados de Referência

Decisões assertivas, tomadas no tempo certo e com a autoridade apropriada. Convertem boas intenções em práticas consistentes. Definem papéis e responsabilidades. Estruturam os processos de governança.


7. Processos de Governança de Dados de Referência

  • Criação de novo Domínio de Referência – Identificação da nescessidade, verificação de sobreposição, definição do data owner, modelagem inicial, aprovação e publicação, documentação e comunicação.
  • Gestão de Mudanças – Formalização das solicitações, triagem, análise de impacto, aprovação, planejamento da implementação, implementação e distribuição e fechamento.
  • Monitoramento – Uso pelos consumidores, nescessidade de novos valores ou domínios, mudança de cocabulário, mudanças no negócio, qualidade da fonte de dados.
  • Auditoria – Valores não cadastrados nas tabelas oficiais, Log de alterações completo e rastraável, mudanças passaram pelo processo formal de aprovação, os Data Owners e Data Stewards estão exercendo seus papéis conforme definido.


8. Criando Dicionário de Dados do Site

Estrutura para Dicionário de Dados do Site
Elemento Descrição Exemplo
Nome do campo Identificador técnico da coluna CNPJ_DISTRIBUIDORA
Descrição Explicação do que o campo representa Número do CNPJ (14 dígitos) da empresa distribuidora do filme
Tipo de dado Formato armazenado string(18), integer, date
Tamanho/Precisão Limite de caracteres ou precisão decimal 18 caracteres
Formato Máscara ou padrão esperado 99.999.999/9999-99
Obrigatoriedade Se pode ser nulo Obrigatório (NOT NULL)
Valores permitidos Domínio de valores válidos Lista de UFs brasileiras
Valor padrão Valor default null
Regras de negócio Restrições ou cálculos Deve ser um CNPJ válido
Origem Sistema/fonte que gera o dado Sistema de bilheteria da ANCINE
Relacionamentos Chaves estrangeiras, dependências FK para tabela distribuidoras
Sensibilidade Classificação na escala (0 -10) registrado manualmente 6
Responsável Data Steward / Owner Equipe de Dados
Frequência de atualização Periodicidade Semestral
Ultima atualização Data da ultima atualização 02/01/2026
valorNegocio Impacto nos objetivos (0-10) registrado manualmente 9
risco Exposição a danos (0-10) registrado manualmente 7
uso Dependência operacional (0-10) registrado manualmente 8
compliance Obrigação externa (0-10) registrado manualmente 10
sensibilidade Grau de restrição (1-10) registrado manualmente 6
prioridade Valor calculado automáticamente por função javascript 8
classificacao Categoria derivada [CRITICO, ALTO, MEDIO, BAIXO] definido manualmente
Se mestre = true então alterar AUTOMATICAMENTE para CRITICO Senão será alterado MANUALMENTE pelo administrador
CRITICO
mestre Classificação se é um dado mestre (VERDADEIRO, FALSO) calculado automáticamente por função javascript VERDADEIRO
Linhagem Referência Hierárquica do Dado Guarda quem é o pai e quem são seus descedentes


8.1 A Importância do Dicionário de Dados

Um dicionário de dados é essencial para qualquer instituição porque transforma dados brutos em ativos estratégicos confiáveis e compreensíveis, funcionando como a “linguagem comum” que alinha áreas técnicas e de negócio em torno de um entendimento único sobre o significado, formato, regras e relacionamentos de cada elemento de dados. Sem ele, diferentes setores interpretam os mesmos campos de formas distintas — gerando relatórios inconsistentes, erros em integrações, retrabalho e decisões baseadas em informações equivocadas —, enquanto sua existência permite padronização, governança, qualidade, rastreabilidade e conformidade regulatória (como LGPD), além de acelerar a integração de novos colaboradores, reduzir custos operacionais e servir de base para iniciativas de Master Data Management, Business Intelligence e Inteligência Artificial. Em resumo: o dicionário de dados é o que separa uma organização que apenas armazena dados de uma que efetivamente governa, confia e extrai valor deles.

9. Glossário de Negócio

Termo Definição de Negócio Campos Técnicos Vinculados
Bilheteria Arrecadação total obtida com a venda de ingressos em um período (dia, semana, mês ou ano). vl_bilheteria
Público Pagante Quantidade de espectadores que efetivamente compraram ingresso para assistir a um filme em uma sessão. qt_publico_pagante
Sessão Exibição de um filme em uma sala específica, em data e horário determinados. dt_sessao, hr_sessao, id_sala
Filme Obra audiovisual exibida nas salas de cinema, identificada por título, gênero e ano de produção. nm_filme, ds_genero, nr_ano_producao
Distribuidora Empresa responsável por levar um filme às salas de exibição, negociando com os exibidores. cnpj_distribuidora, nm_distribuidora
Exibidor Empresa proprietária das salas de cinema (rede ou cinema independente) que exibe os filmes ao público. cnpj_exibidor, nm_exibidor
Sala de Cinema Espaço físico dentro de um complexo de exibição, com capacidade de assentos definida. id_sala, qt_assentos
Complexo Conjunto de salas de cinema localizado em um mesmo endereço, sob mesma administração. id_complexo, nm_complexo
Município Divisão territorial oficial do IBGE onde o cinema está localizado. É a unidade geográfica básica da análise. cod_municipio_ibge, nm_municipio
Estado (UF) Unidade federativa brasileira, usada para agregações regionais. sg_uf, nm_uf
Período Intervalo de tempo usado para agregação das análises (dia, semana, mês, ano). dt_inicio, dt_fim
Remessa de Filme Envio de uma cópia (física ou digital) de um filme para uma sala de exibição. id_remessa, dt_remessa
Fonte Oficial Órgão ou base pública de onde o dado foi originalmente extraído (ex.: ANCINE, IBGE, TRE). nm_fonte, url_fonte


10. Glossário Técnico

Termo Definição de Negócio Campos Técnicos Vinculados
plantuml linguagem textual para criação de diagramas UML, usada para representar grafos de linhagem, arquitetura de dados e relações entre elementos. Modo de uso

 
postagem
latex linguagem textual para criação de fórmulas. Modo de uso

 
postagem

11. Calcular ‘valor de prioridade’ para os Dados com função JavaScript

Após calcular o valor de prioridade de cada dado deve se ordenar da maior prioridade para a menor prioridade a lista.
Neste caso dado tem as informações principais do dicionario de dados.
O objetivo é definir o que devemos trabalhar primeiro dependendo da prioridade definida nesta lista.

O valor de prioridade é calculado considerando os características e seu peso :

  • valorNegocio : Mede o impacto positivo do dado nos objetivos da empresa — receita, decisões estratégicas, vantagem competitiva, eficiência operacional.
  • risco : Mede a exposição a danos — financeiros, regulatórios, reputacionais ou operacionais.
  • uso : Mede a dependência operacional — quantos processos, dashboards, APIs ou áreas dependem dele.
  • compliance : Mede a obrigação externa — LGPD, GDPR, BACEN, ANS, SOX, contratos, auditorias.
  • sensibilidade : Mede o grau de restrição de acesso — público, interno, confidencial, restrito.

O peso representa a importância que a instituição dá a uma característica, por isso o valor da característica é multiplicado pelo peso.

Essas características (valorNegocio, risco, uso, compliance, sensibilidade) são metadados de governança e devem estar no dicionário de dados, pois:

  1. São atributos do dado — descrevem o dado tanto quanto tipo, tamanho e descrição
  2. São auditáveis — em auditorias, você precisa justificar por que um dado é tratado como crítico
  3. São dinâmicos — mudam com o tempo (ex: um dado pode ganhar valor de negócio com uma nova estratégia)
  4. Alimentam decisões — definem o que priorizar, mascarar, proteger, documentar melhor
  5. Fazem parte da governança — são a base para políticas de acesso, retenção e qualidade

Diferença entre Prioridade e Classificação: Após o calculo da Prioridade já temos uma primeira classificação mas a Classificação entra como complemento para desempate e será feito manualmente pelo administrador.

12. Calcular se um dado é um ‘dado mestre’ com função JavaScript

13 – Mapa de Papéis

Exemplo de Mapa de Papéis em uma instituição de médio e grande porte

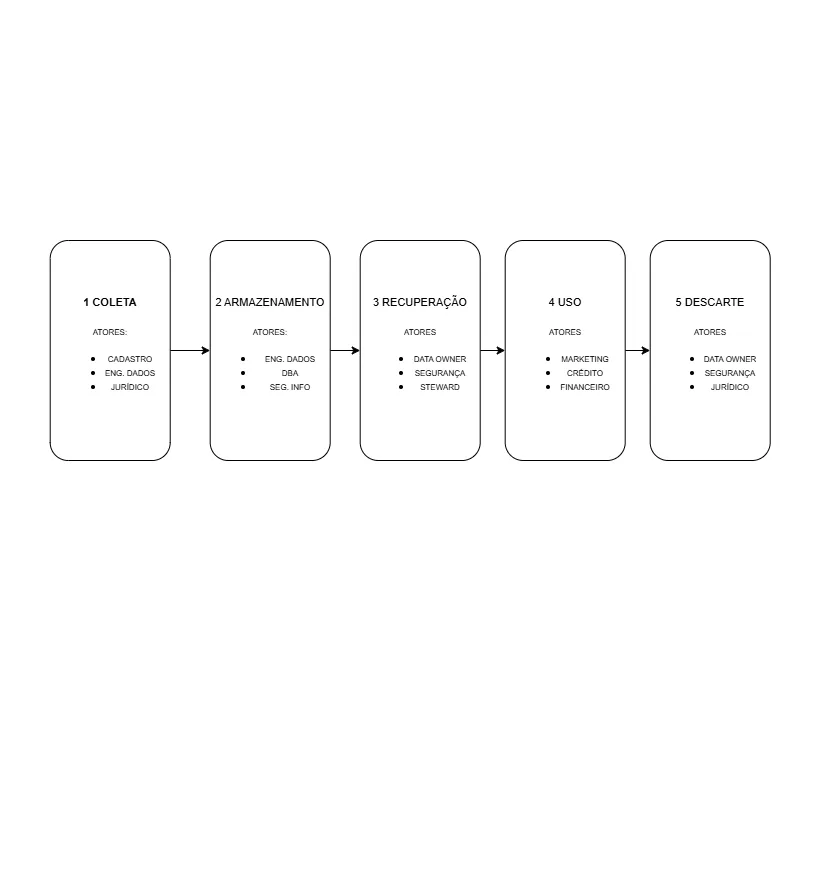
14 – Ciclo de vida do dado

Ciclo de vida dos dados

14 – COLETA

14.1 — Coleta de dados

Selecionado Item Etapa Descrição
■ 14.1 Coleta Fazer download de arquivos originais (xml, csv, json…) criando um
Lago de Dados em HD secundário.
■ 14.2 Validação e avaliação de qualidade Avaliar a qualidade dos dados coletados considerando as dimensões:
Acurácia, Consistência, Completude, Atualidade, Unicidade e Credibilidade.
As dimensões abaixo devem ser consideradas para avaliar a qualidade de dados.

14.1.2— DIMENSÕES DE AVALIAÇÃO DE QUALIDADE


Selecionado Item Dimensão Descrição
■ 14.1.2.1 Acurácia Grau em que o dado representa corretamente o evento, objeto ou realidade que descreve.
■ 14.1.2.2 Consistência Grau em que o dado é uniforme entre sistemas, fontes e ao longo do tempo, sem contradições internas.
■ 14.1.2.3 Completude Grau em que todos os dados necessários estão presentes, sem valores ausentes ou campos em branco indevidos.
■ 14.1.2.4 Atualidade Grau em que o dado está disponível no momento esperado e reflete o estado mais recente da realidade.
■ 14.1.2.5 Unicidade Grau em que cada registro representa uma única entidade, sem duplicidades indevidas.
■ 14.1.2.6 Credibilidade Grau em que a fonte, o processo e o conteúdo do dado são confiáveis e verificáveis.


14.2 Correção (Definir procedimentos antecipadamente, gerar Log para auditoria

14.3 Resultado (DataFrame python)


15 – ARMAZENAMENTO 

Armazenar novos dados em Tabela de BD o que permitirá criar Visões para consultas e gerar JSON a partir delas, que alimentarão o site.

16 – RECUPERAÇÃO 

Manter Backup’s dos Schemas e dos Dados das Tabelas

17 – USO 

Os dados serão usados no site para apresentar gráficos iterativos em Análise de Dados.

18 – DESCARTE

Os dados poderão ser descartados se não estiverem sendo mais utilizados em Análise de Dados, tendo em vista que os dados permanecerão na fonte dos dados.
OBSERVAÇÂO: Nossa fonte principal vem de ‘Dados Abertos GovBr‘, mas sempre informaremos a fonte de dados no dicionário de dados (em desenvolvimento) e na página onde será exibidos os gráficos.


15 – Contexto

Contexto é toda informação que não é o dado em si, mas que dá significado a ele.
O Contexto será atribuído a um assunto/gráfico por meio de um JSON onde guardaremos data, descrição histórica e fonte.
Exemplo como seria unir dados do preço do barril de petróleo com o contexto:

Fontes de Contextos utilizados no site

Nome Fonte resultado
Fatores Geopolíticos e o Preço do Petróleo  

  • FT Mercati / EnergyNow.ca (Yogi Schulz)
  • World Economic Forum
  • Philip Verleger LLC
  • Permutable AI
  • Báo Công Thương (Vietnã)
  • Poznań University
  • UK Parliament Research Briefing
  • EIA (Hamilton, 2022)
  • FERC
  • World Bank
  • Planete Energies
  • PEA
JSON


16 – Tabela de Procedimentos para atualização

Passo Atualizar Procedimento
1 Dado Mestre – Estados e Municípios (atualizada pelo JSON)
  1. Em meu sistema administrativo fastHTML executar etl_coordenadas_municipios.py
  2. Salvará municipios_brasil_coordenadas.json na pasta etl
  3. Fazer UPLOAD do arquivo municipios_brasil_coordenadas.json no site (…/uploads/2025/07) onde ficará PÚBLICO e servirá de base para outros projetos de análise de dados.
  4. Verificar em https://www.areadetrampo.com.br/municipios-brasileiros/ se a data de atualização está atualizada antes de continual para o próximo passo.
2 Contexto – Fatores Geopolíticos e o Preço do Petróleo
  1. Fazer nova pesquisa
  2. Atualizar a Pagina sobre Fatores Geopolíticos e o Preço do Petroleo
  3. Atualizar manualmente projeto/etl/municipios_brasil_coordenadas.json e fazer upload manualmente em  (…/uploads/2025/07/eventos_geopoliticos_barril_petroleo.json)
3 Todas as Análises de Dados
  1. coleta (baixar todos os arquivos em pasta LAGO_DE_DADOS)
  2. validação (Procedimento no Python para verificar Completude, Unicidade, Validade, Consistência, Acurácia, Tempestividade, Integridade Referencial e Aderência a regras de negócio) e ao mesmo tempo avaliar a qualidade dos dados (contabilizando resultado e guardando os resultados históricos para posteriormente mensurar melhorias na qualidade dos dados e fazer auto avaliação)
  3. correção
  4. padronização (conversão de formato de data padrão Área de Trampo DD/MM/AAAA)
  5. resultado (dataframe python)
  6. armazenamento em BD e/ou JSON Pública
  7. recuperação – Backup BD físico e nuvem (script + dado) e GitHub
  8. uso – Atualização de Gráficos em Análise de Dados + documentação pública + transparência + aprendizagem + divulgação de cultura de gestão de dados + feedback colegas de curso


17 – Sucesso a Longo Prazo

Resultados sustentáveis impulsionados por dados confiáveis

LinkedIn
Share
Instagram